안녕하세요, import ysy입니다!
p-value, p값이라는 수치를 본 적 있으신가요?
연구를 하다보면
“우리 모델이 기존 모델보다 정확도가 2% 높아졌다.
그러면 정말 우리 모델이 더 좋은 걸까?”
이라는 질문이 생깁니다.
단순히 실험 결과의 숫자가 더 높다고 해서
그 차이가 통계적으로 의미 있는 차이라고 바로 말할 수는 없습니다.
실험을 반복하다 보면 데이터의 구성이나 초기화, 학습 과정의 randomness 때문에
우연히 성능 차이가 발생할 수 있기 때문이죠.
이때 등장하는 개념이 바로 p-value(유의확률)입니다!
오늘 내용 헷갈리고 긴 편이라 잘 따라오세용
1. p-value란?
실제로 차이가 없다고 가정했을 때, 지금 관찰한 결과만큼 또는 그보다 더 극단적인 결과가 우연히 나타날 확률
그러니까, p값은 작을 수록 좋은 값이죠.
우리는 이 확률값이 통상 0.05보다 작을 때 유의미하다고 봅니다.
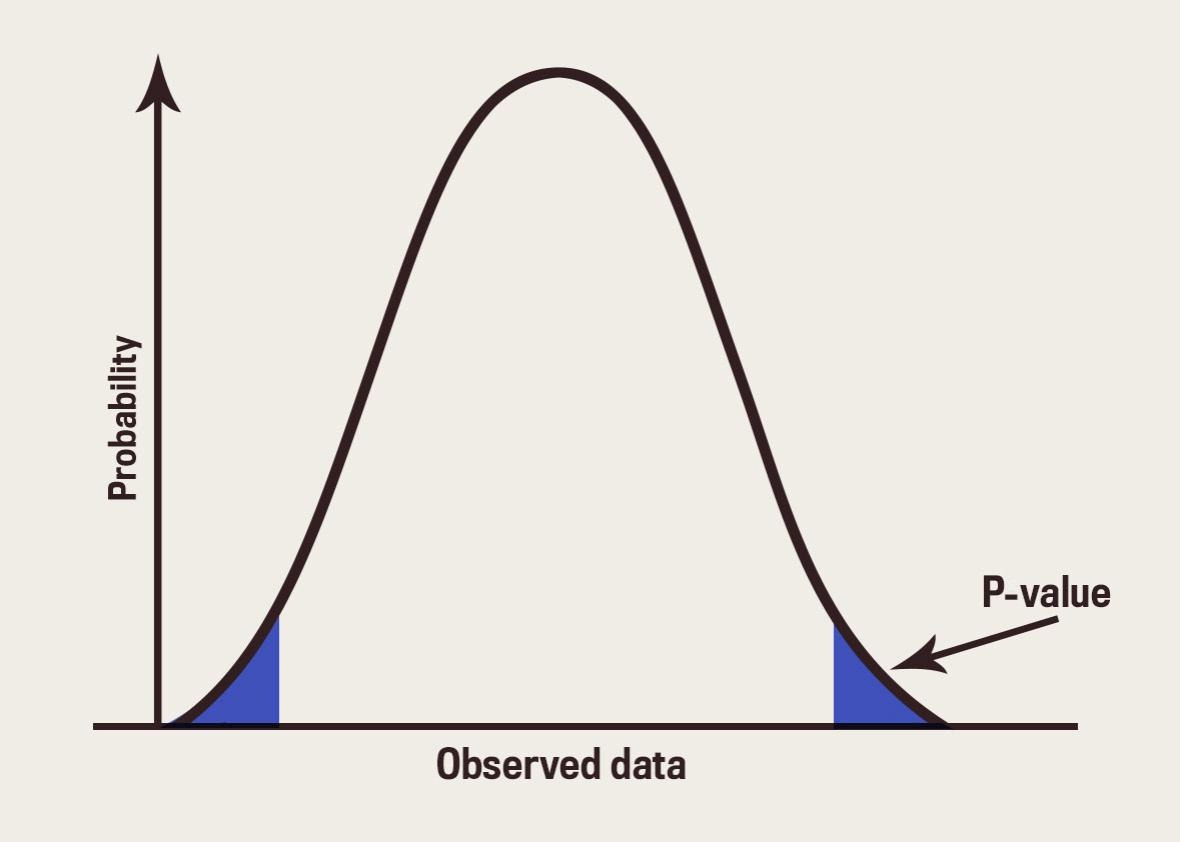
예를 들어볼게요!
어떤 ASR 모델 두 개를 비교해볼게요.
| Baseline | 8.2% |
| Proposed | 7.5% |
Proposed 모델의 CER이 0.7%p 낮은 상황입니다.
그렇다면 우리는 자연스럽게
“Proposed 모델이 더 좋은 것 아닌가?”
라고 생각할 수 있어요.
하지만 이 차이가 실제로 모델의 성능 차이 때문인지,
아니면 실험 과정에서 우연히 발생한 것인지는 별도의 문제입니다.
그래서 아래와 같이 통계적 가설을 세워 볼게요.
귀무가설(H₀)
Baseline과 Proposed 모델의 실제 성능에는 차이가 없다.
대립가설(H₁)
Baseline과 Proposed 모델의 실제 성능에는 차이가 있다.
여기서 p-value는 귀무가설(H₀)이 참이라고 가정했을 때
현재 결과가 얼마나 놀라운지를 나타내는 값이 됩니다.
그리고 이 가설을 검정한 결과는 p값으로
p = 0.03
이라고 나왔습니다.
이는
실제로 두 모델의 성능에 차이가 없다고 가정했을 때, 현재 관찰한 것만큼 큰 차이가 우연히 나타날 확률이 약 3%
라는 의미입니다.
따라서 일반적으로 사용하는 유의수준 α = 0.05와 비교하면,
p < 0.05 → 통계적으로 유의하다
고 판단할 수 있는 것이지요.

2. p-value가 작으면 무조건 좋은 것일까?
그렇지는 않습니다!
p-value는 모델이 얼마나 좋은지를 나타내는 지표가 아니거든요.
예를 들어 다음 두 결과를 비교해볼게요.
실험 A
- Baseline CER: 8.20%
- Proposed CER: 8.19%
- p = 0.001
실험 B
- Baseline CER: 8.20%
- Proposed CER: 7.50%
- p = 0.08
실험 A에서는 p-value가 매우 작지만 실제 성능 차이는 0.01%p에 불과해요.
반면 실험 B에서는 성능 차이가 0.70%p나 나지만 p-value가 0.05보다 크죠.
따라서 p-value만 가지고
“p-value가 작으니까 이 모델이 더 좋다.”
라고 결론 내리는 것은 적절하지 않습니다.
실험에서는 차이의 크기(effect size)와 통계적 유의성(statistical significance)을 구분해서 봐야 합니다.
3. p-value는 언제 필요할까?
그렇다면 모든 AI 실험에서 p-value를 계산해야 할까요?
그렇지는 않습니다.
핵심은 “내가 관찰한 성능 차이가 우연에 의한 것인지 판단해야 하는가?”입니다.
① 두 모델의 성능 차이를 주장하고 싶을 때
가장 대표적인 경우죠.
예를 들어 논문에서
“Proposed method significantly outperforms the baseline.”
와 같이 통계적으로 유의한 성능 향상을 주장하려면 통계 검정이 필요합니다.
특히 두 모델의 성능 차이가 크지 않을 때는 더욱 중요하죠.
그런데 항상 논문에 p값을 첨부하지는 않더라고요.
② 동일한 조건에서 여러 번 실험했을 때
딥러닝 모델은 학습 과정에서 randomness가 존재합니다.
예를 들어 random seed를 바꿔가며 5회 실험했다고 할게요.
Baseline
8.21, 8.35, 8.17, 8.29, 8.24
Proposed
7.81, 7.95, 7.73, 7.88, 7.79
이 경우 단순히 평균만 비교하는 것보다
“이 두 분포의 차이가 통계적으로 유의한가?”
를 검정할 수 있습니다.
이때 t-test나 Wilcoxon signed-rank test 등의 방법을 고려할 수 있는데,
이 내용은 약간 복잡해서 여기서는 넘어갈게요..!
③ 데이터가 제한적인 실험에서
특히 Low-resource Learning처럼 데이터가 적은 환경에서는
작은 데이터 변화에도 결과가 달라질 수 있습니다.
예를 들어 데이터셋의 일부를 바꾸거나
random seed를 변경했을 때 성능 차이가 크게 변한다면,
“이번에 나온 성능 향상이 정말 일반적인 현상인가?”
라는 질문이 중요해져요.
이런 경우 반복 실험과 통계적 검정을 함께 고려할 수 있습니다.
4. p < 0.05 기준이 절대적이진 않음!
실험에서 흔히 볼 수 있는 기준이
p < 0.05
입니다.
하지만 이것을 잘못 이해하는 경우가 많습니다.
❌ 잘못된 해석
p = 0.03이므로 Proposed 모델이 더 좋을 확률이 97%다.
이것은 아니예요.
⭕ 올바른 해석
두 모델 사이에 실제 차이가 없다는 귀무가설을 가정했을 때, 현재 관찰한 정도 이상의 차이가 나타날 확률이 약 3%이다.
즉 p-value는 귀무가설이 참일 확률도 아니고, 대립가설이 참일 확률도 아닌 것이지요.
5. p-value 외에 또 중요한 것들
추가로.. 특히 모델 평가할 때 제가 확인하는 순서는 다음과 같습니다.
참고해주세요
① 성능 차이
얼마나 개선되었는가?
② p-value
그 차이가 우연히 발생했다고 보기 어려운가?
③ Effect Size
실제로 차이가 얼마나 큰가?
④ Confidence Interval
성능 차이의 불확실성 범위는 어느 정도인가?
⑤ 반복 실험 결과
Random seed 등을 바꿔도 비슷한 결과가 나오는가?
오늘 내용이 많았는데 도움이 되셨으면 좋겠습니다!
읽어주셔서 감사해요
'전공 > 인공지능, ML, DL' 카테고리의 다른 글
| EER(Equal Error Rate), 등가 오류율이란? (0) | 2026.09.21 |
|---|---|
| OpenAI API key 발급, LLM 사용하기 (0) | 2025.07.25 |
| 언어모델 LM의 역사 정리 (2) | 2024.11.10 |
| Weights and Biases(W&B), wandb 소개 (0) | 2024.10.08 |
| Stable Audio Open finetuning 파인튜닝 / 코드 공유 (1) | 2024.08.29 |


댓글